Tag Archives: XML

「Antenna House AHPDFXML 変換ライブラリ V2.0」の利用例

「Antenna House AHPDFXML 変換ライブラリ V2.0」は、PDFファイルの内部データを、XML(Extensible Markup Language:拡張可能なマークアップ言語)形式に変換するプログラムです。このライブラリが出力するXML形式を「AHPDFXML形式」と呼びます。PDF解析技術により文書構造を生成して、再利用に適したXMLデータを出力します。

「AHPDFXML形式」で表現された様々な情報から、必用な情報を読み取ることでPDFのデータを簡単に再利用できます。

  • 文字や画像の位置情報を利用することで、任意の範囲に含まれるデータを取り出せます。
    例えば、アンケートに使用したPDFの回答欄の文字列だけ取り出すことができます。
    例えば、特定の文字列や画像を含むPDFを探すことができます。
  • 表構造をデータベースに取り込むことにより、データのグループ化がおこなえます。
    PDFには表と言う概念はありませんが「AHPDFXML形式」は、表構造(行列及びセル)を生成します。
    これにより、文字としてでは無く、表としてデータを再利用できます。
    例えば、表構造をCSVに落とすことにより、表計算ソフトに取り出込めます。

XMLで表現することによって、データの扱いが容易になります。
XMLのメリットを最大限に活かしてPDFデータを活用できます。
弊社ウエブサイトより評価版の申し込みが可能です。是非ご評価ください。

製品に関するご質問は
sis@antenna.co.jp(SYSTEM担当)
または
oem@antenna.co.jp(OEM担当)
まで、お気軽にお問い合わせください。

評価版のお申込
評価版のお申込ページ

Webページ
https://www.antenna.co.jp/pdfxml/

「Antenna House AHPDFXML 変換ライブラリ V2.0」の概要

「Antenna House AHPDFXML 変換ライブラリ V2.0」は、PDFファイルの内部データを、XML(Extensible Markup Language:拡張可能なマークアップ言語)形式に変換するプログラムです。このライブラリが出力するXML形式を「AHPDFXML形式」と呼びます。PDF解析技術により文書構造を生成して、再利用に適したXMLデータを出力します。

PDFのデータは、文字、線、画像などが配置されているだけで、文字は見た目順に格納されているとは限らず、段落や表と言う概念もありません。本ライブラリでは、PDFのデータを単にXML化するだけで無く、文書構造を生成して、再利用に適したXMLデータを出力します。「AHPDFXML形式」として出力される主な情報は次の通りです。

  • 段落、行、パラグラフなどの文書情報を生成。
  • 線画情報から、水平/垂直の線分を抜き出して、表構造(行列及びセル)を生成。
  • 文字を見た目順に再配置してから出力。
  • 文字情報は、位置、フォント情報などを出力。
  • 画像情報は、位置、種別などを出力。
  • 画像本体は外部ファイルとして出力。

XMLで表現することによって、データの扱いが容易になります。
XMLのメリットを最大限に活かしてPDFデータを活用できます。
弊社ウエブサイトより評価版の申し込みが可能です。是非ご評価ください。

製品に関するご質問は
sis@antenna.co.jp(SYSTEM担当)
または
oem@antenna.co.jp(OEM担当)
まで、お気軽にお問い合わせください。

評価版のお申込
評価版のお申込ページ

Webページ
https://www.antenna.co.jp/pdfxml/

AH Formatter:縦書きのテーブルセルについて

こんにちは。
AH Formatterサポート担当です。
今週はAH Formatterのサポートで比較的よくあるご質問を紹介いたします。

今回は、縦書きのテーブルセルについて、です。
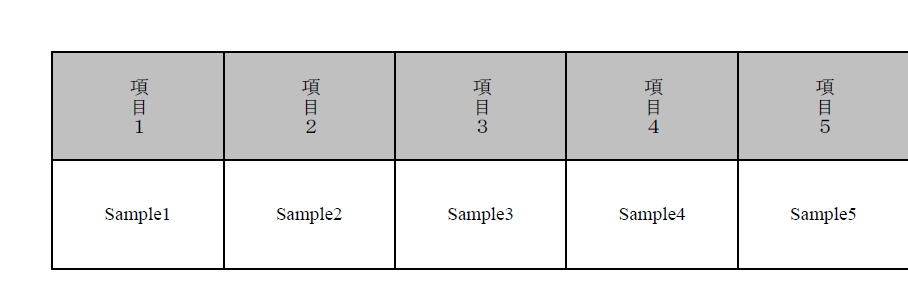
横書きの文書でも、テーブルヘッダだけ縦書きにしてセンタリング配置したいことってありますよね。
例えば、こんな感じ。
縦書きのテーブルセルについて

このように配置するための方法を順を追って説明します。

Continue reading →

AH Formatter:”.precedence” の効果について

こんにちは。
AH Formatterサポート担当です。
今週はAH Formatterのサポートで比較的よくあるご質問を紹介いたします。

今回は、.precedence について、です。
XSL-FOの仕様の中で、space-before や space-after などのプロパティで Value に <space> が定義されているものがあります。

7.11.5 “space-before”
では、以下のように書かれています。

 XSL Definition:
 Value: <space> | inherit
 Initial: space.minimum=0pt, .optimum=0pt, .maximum=0pt, .conditionality=discard, .precedence=0

さらに
5.11 Property Datatypes
の中で、<space> の説明があります。

 A compound datatype, with components: minimum, optimum, maximum, precedence, and conditionality.

つまり、Value に <space> とあるプロパティについては
space-before.minimum=”2.0pt”
space-before.optimum=”3.0pt”
space-before.maximum=”4.0pt”
space-before.precedence=”0″
space-before.conditionality=”discard”
のような使い方ができます。

この中の “.precedence” について
どのような意味を持っているのか?
使い方がよくわからないというご質問を受けることがあります。

.precedence は指定値が競合するような場合の解決に用います。
競合した場合の強さを整数または”force”(最も強い)で表します。

space-after/space-beforeを例にしますと、

 <fo:block space-after=”2cm”>1のブロック</fo:block>
 <fo:block space-before=”1cm”>2のブロック</fo:block>

このような場合、どちらのblockも .precedence は指定されていないので
値は初期値の0です。したがって、
1のブロックと2のブロックの間の space は、
大きいほうの値が選択され、2cmとなります。

補足:
スペース指定子のこのような法則は
4.3.1 Space-resolution Rules
に定義されています。

次に、2のブロックに space-before.precedence=”force” を指定します。

 <fo:block space-after=”2cm”>1のブロック</fo:block>
 <fo:block space-before=”1cm” space-before.precedence=”force”>2のブロック</fo:block>

space-before の方が強制力を持つので、space は1cmになります。

次に両方に .precedence=”force” を指定すると、

 <fo:block space-after=”2cm” space-after.precedence=”force”>1のブロック</fo:block>
 <fo:block space-before=”1cm” space-before.precedence=”force”>2のブロック</fo:block>

両方とも強制的に space を出力するので、間の space は3cmとなります。

このような使い方を知っていると、章タイトル/節タイトルや本文との空きを調節するのに
便利なことがあるかもしれません。

参考資料
『XSL-FOの基礎』 6.8 複合データ型
 

AH Formatter:Windows版と非Windows版との違い(組版機能に違いはありません)

こんにちは。
AH Formatterサポート担当です。
今週はAH Formatterのサポートで比較的よくあるご質問を紹介いたします。

AH FormatterはWindows版、Linux版、Solaris版、Macintosh版など種々のOSに対応したバージョンがございます。
お客様のご利用環境に合わせたバージョンを選択されるのはもちろんですが、
例えば、Windows版とLinux版とでどちらがいいのか?違いがあるのか?といったご質問を受けることがあります。

AH Formatterの「組版機能」に関してはWindows版と非Windows版とで違いはありません。
ただし、Windows版以外では実行のためにいくつか設定等を行っていただく必要があります。

・AH FormatterのGUIはWindows版のみの機能です。

・非Windows版では直接プリンタへ出力することはできません。プリンタへ直接印刷指定できるのはWindows版のみの機能です。

・AH Formatterはフォントファイルを含みません。
 非Windows版では欧文基本14フォントのみインストールされますが、これはメトリクス情報ファイルのみ含まれます。
 フォントのアウトライン情報ファイルは含まれません。これらのフォントをPDFやPSに埋め込もうとする場合は、ご自身でフォントをご用意ください。
 それ以外のフォントのインストールはお客様の環境にて行ってください。
 Windows版ではインストール時にWindowsのフォントフォルダを参照するように設定されますが、
 非Windows版ではフォント構築ファイルにてお客様の環境に合わせて設定していただく必要があります。

・AH FormatterはXSLTプロセッサは含みません。
 Windows版は通常MSXMLがインストールされていますので(特に指定がない限り)それを自動的に使用しますが
 非Windows版ではお客様がXSLTプロセッサを選択、インストールしていただいたのち、
 オプション設定ファイルや環境変数にて使用するXSLTプロセッサを指定していただく必要があります。

・非Windows版では環境変数を設定する必要があります。
 Windows版ではインストール時に初期設定されますが非Windows版では設定されません。
 必要な環境変数はオンラインマニュアルの「環境変数」でご確認ください。


AH Formatter 機能のご紹介:CGM の描画(ISO/IEC 8632、WebCGM 2.1)

CGM(Computer Graphics Metafile)[1]は、ベクトルグラフィックスを表現する標準ファイル形式です。ISO/IEC 8632 の CGM[2] 及び W3C のWebCGM[3]で規定されています。自動車製造・航空機製造・機械などの製造業で良く使われています[4]。

『AH Formatter』はCGMとWebCGMを独自開発したエンジンにより描画し、描画した結果を画面に表示したり、印刷したり、PDFの中に線画(ベクタ画像)として作成できます。

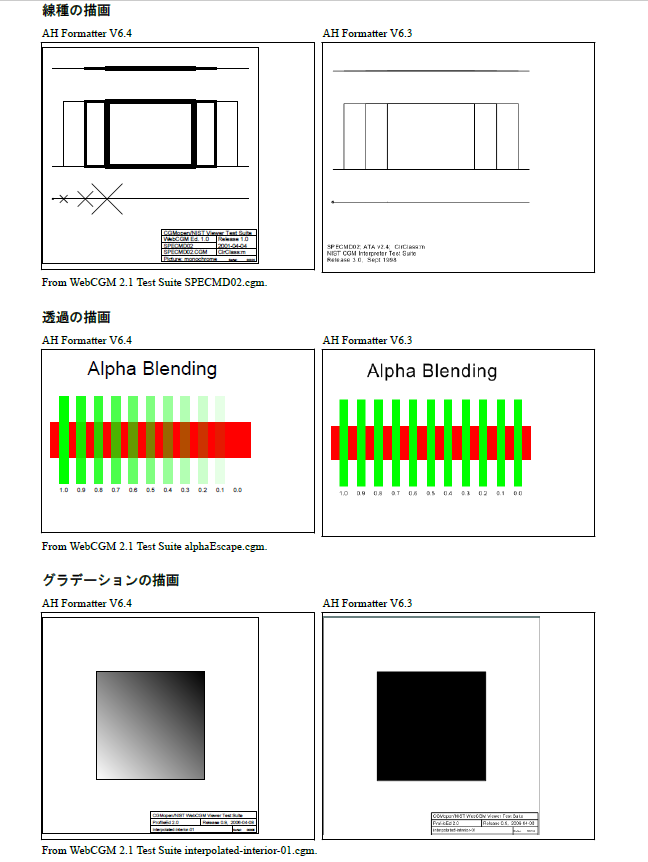
CGM はベクタ画像として出力されるため画質は劣化せず高い解像度で描画することが可能です。また、『AH Formatter V6.4』において描画エンジンを完全に書き替え、これまで以上に多くの要素へ対応いたしました。
→ CGM仕様の実装状況(オンラインマニュアル)

一部ですが、V6.4 において新たに対応した描画を V6.3 と比較した結果を紹介します。
AH Formatter の CGM 描画

CGM 画像は W3C の Test Suite より引用しております。
引用元:WebCGM 2.1 Test Suite. “Copyright © 2002-2006, Lofton Henderson. All Rights Reserved.”

『AH Formatter』のサンプルFO集には、本機能の動作が確認できるサンプル「グラフィクス CGM の表示 (<fo:external-graphic>)」を掲載しております。

なお、CGM を描画するには、『AH Formatter CGM オプション』をご購入していただく必要があります。

『AH Formatter』は主にバージョンアップのたびに機能強化や新機能の追加を行っています。
“あったら便利な機能” も既に追加されていることがございますので、どうぞお気軽にサポートにお問い合わせください。
未実装の機能であれば、ご要望として承り、今後の開発の参考にさせていただきます。

『AH Formatter』の評価版にて CGM の描画をお試しいただけます。
評価版は次のページよりお申し込みいただけます。ご興味のある方は是非お試しください。
→ AH Formatter 評価版のお申し込み

[1] Computer Graphics Metafile
[2] ISO/IEC 8632-1:1999
[3] WebCGM 2.1
[4]HP Designjet Printers – Usage of the Computer Graphics Metafile (CGM)-Who uses CGM?

※3月26日冒頭部分を更新

XSLTを学ぶ(9) ステップの文法を追求する-述部(Predicates)と式

第3回[1]からパスの文法を調べてきました。パスの重要な構成要素にステップがあり、ステップ(省略)は軸、ノードテスト、述部(オプションなので必須ではない)から構成されることを調べました。

ステップの最後の構成部品はオプションの述部です。第6回[2]で見ましたが、述部は式を[]で囲った形式です。

式とはどんなものでしょうか? まず、XPathの式の生成規則[3]をトップから辿ってみます。

スタートは定義の[14]ですが、式Exprとは、OrExprです。[21]orExprはAndExprを’or’でつなげたものです。そして、[22]AndExprとは、EqualityExprを’and’でつなげたものです。[23]EqualityExprは、RelationalExprを’=’でつなげたものまたは’!=’でつなげたもの。[24]RelationalExprは、AdditiveExprを'<‘ ‘>”<=’ ‘>=’でつなげたもののようです。つまり、このあたりまでは、式はAdditiveExpr(加算式)の論理演算ということになります。

[14] Expr ::= OrExpr
[21] OrExpr ::= AndExpr | OrExpr ‘or’ AndExpr
[22] AndExpr ::= EqualityExpr | AndExpr ‘and’ EqualityExpr
[23] EqualityExpr ::= RelationalExpr
| EqualityExpr ‘=’ RelationalExpr
| EqualityExpr ‘!=’ RelationalExpr
[24] RelationalExpr ::= AdditiveExpr
| RelationalExpr ‘<‘ AdditiveExpr | RelationalExpr ‘>’ AdditiveExpr
| RelationalExpr ‘<=’ AdditiveExpr | RelationalExpr ‘>=’ AdditiveExpr

ということで、さらにAdditiveExprとは何かを見てみます。[25]ではAdditiveExprは、MultiplicativeExprを’+’または’-‘でつなげたものです。

[25] AdditiveExpr ::= MultiplicativeExpr
| AdditiveExpr ‘+’ MultiplicativeExpr
| AdditiveExpr ‘-‘ MultiplicativeExpr

[26]ではMultiplicativeExprとは、UnaryExpr(単項式)、またはMultiplicativeExprにUnaryExprを掛けた(’*’)、またはMultiplicativeExprをUnaryExprで割り算(’div’)、剰余算(’mod’)したものです。
[26] MultiplicativeExpr ::= UnaryExpr
| MultiplicativeExpr MultiplyOperator UnaryExpr
| MultiplicativeExpr ‘div’ UnaryExpr
| MultiplicativeExpr ‘mod’ UnaryExpr
[34] MultiplyOperator ::= ‘*’

UnaryExprは、UnionExprまたはその前にマイナス記号(’-‘)をつけたもの。

[27] UnaryExpr ::= UnionExpr | ‘-‘ UnaryExpr

UnionExprは、ひとつのPathExpr(パス式)、またはそれを’|’で結合したものです。

[18] UnionExpr ::= PathExpr| UnionExpr ‘|’ PathExpr

PathExpr式は、LocationPath(ロケーションパス)、またはFilterExprまたは、FilterExprと相対ロケーションパスを’/’、’//’ で結合したものです。

[19] PathExpr ::= LocationPath
| FilterExpr
| FilterExpr ‘/’ RelativeLocationPath
| FilterExpr ‘//’ RelativeLocationPath

ロケーションパスについては第3回[2]ですでに学びましたが、XMLツリーのノードを選択するものです。ノードの選択結果はノードの集まり(ノード集合)ですが、これに対して、掛け算(’*’)、割り算(’div’)、剰余算(’mod’)、足し算(’+’)、引き算(’-‘)、比較などの演算をするのは少し不思議な気もします。これは後ほど調べてみることにします([5])。

FilterExprの方は、PrimaryExprまたはPrimaryExprに述部(Predicate)を付けたものとなります。ここに出てくる述部はFilterExpr Predicateのように使われますが、ステップの中で出てくる述部の使われ方はAxisSpecifier NodeTest Predicate*です。この2種類の述部の使われ方の違いはなんでしょうか? これも後ほど調べてみましょう([4])。

PrimaryExprは、VariableReference(変数参照)、式を()で囲ったもの、リテラル、数値、FunctionCall(関数呼び出し)のどれかです。ですので、式には数置の四則演算も表現したものも含まれます(よく知っている初歩的な数式も含まれるということで一安心です)。

[20] FilterExpr ::= PrimaryExpr
| FilterExpr Predicate
[15] PrimaryExpr ::= VariableReference
| ‘(‘ Expr ‘)’
| Literal
| Number
| FunctionCall

最も単純なケースでは、一つの数値(Number)だけでも式となります。例えば、次のように下から辿ってみます。
(1) PrimaryExprがNumber:100
(2) FilterExprがPrimaryExpr:100
(3) PathExprがFilterExpr:100
(4) UnionExprがPathExpr:100
(5) UnaryExprがUnionExpr :100
(6) MultiplicativeExprがUnaryExpr:100
(7) AdditiveExprがMultiplicativeExpr:100
(8) RelationalExprがAdditiveExpr :100
(9) EqualityExprがRelationalExpr :100
(10) AndExprがEqualityExpr:100
(11) OrExprがAndExpr:100
(12) ExprがOrExpr:100

ということで、述部に[100]と書くことができます。

まとめますと、述部([]内)には式を書きますが、式としてはロケーションパスを書くこともできますし、また、数値、変数、関数呼び出し、数式を書くこともできる、ということになります。

途中で、いろいろわからない言葉が出てきていますので、次回以降、もう少し詳しく調べてみます。

[1] XSLTを学ぶ (3) パスとは
[2] XSLTを学ぶ (6) ステップの文法を追求するの[8]、[9]式
[3] 3 Expressions
[4] 次回(第10回)のpreceding::foo[1] と(preceding::foo)[1]の比較 の項を参照してください。
[5] ノード集合の論理演算、比較演算については第11回を参照してください。

【広告】★AH Formatter XML関連出版物の紹介

次回:
XSLTを学ぶ (10)式によるノード集合の作成、ノード集合の和集合、フィルター式

前回:
XSLTを学ぶ(8)ステップの文法を追求する-NodeTest

初回:
XSLTを学ぶ(1)XMLのツリーモデルとXPath/XSLTのツリーモデルではルートの意味が違う
XSLTを学ぶ (1) XMLのツリーモデルとXPath/XSLTのツリーモデルではルートの意味が違う

先月『スタイルシート開発の基礎』[1]という本を出版しました。この本は、副題に「XMLとFOで簡単な本を作ってみよう」とあるとおりXSLTの実践学習本です。現在、弊社の社内でも、初心者が集まって、この本を使ってXSLTの学習をはじめたところです[2]。私もメンバーの一人です。

『スタイルシート開発の基礎』のはじめにには「XSLT/XPathの知識はない」人が本書の対象とあります。私もXSLTを本格的に学ぶのは初めてですので、本書の想定読者にあてはまりそうです。

素直に読めば、この本だけで理解できるのかもしれませんが、折角ですので、他の参考資料や仕様書をにらみ合わせて楽しみながらお勉強。そこで、折角学んだことを整理して、紹介したいと思います。すでにご存知の方には、初歩的なお話と思いますが、『スタイルシート開発の基礎』の補足として役立てていただけるかもしれません。

資料としては次を見ています。

・『XSLTバイブル』(Michael Kay著、インプレス社、2002年1月発行)
・XSL Transformations (XSLT) Version 1.0(W3C Recommendation 16 November 1999)[3]
・XML Path Language (XPath) Version 1.0(W3C Recommendation 16 November 1999, revised 7 September 2015)[4]

さて、今回勉強し始めて知ったのですが、整形式XMLのツリーモデルとXSLT/XPathのツリーモデルはまったく違うんですね。

XML1.0では、整形式XML文書はルートが文書の実体ツリーの起点であり、XMLプロセサはルートから処理を始めます。さらに見ますと、ルートまたは文書要素と呼ばれる要素が唯一あるとされています。ルート要素は他の要素の内容になりません(つまり親を持ちません)が、他の要素は親を持ちます[5]。整形式XML文書はルート要素(文書要素)を起点とする要素のツリー構造になります。

しかし、XPathのデータモデルは、ノードという概念が中核です。ノードの種類として次の7つがあります。
・ルートノード(root nodes)
・要素ノード(element nodes)
・テキストノード(text nodes)
・属性ノード(attribute nodes)
・名前空間ノード(namespace nodes)
・処理命令ノード(processing instruction nodes)
・コメントノード(comment nodes)

原文でroot nodesと複数形になっているのが気になりますが、XPath仕様の5.1 ルートノード(Root Node)には、「ルートノードはツリーのルートであり」、「文書要素ノードはルートノードの子である」、「ルートノードの子供として、処理命令、処理命令のためのコメント、プロローグの中の文書要素の後のコメントノードがある。」とあります。

また、XSLT仕様の3 データモデル(Data Model)を見ますと、XSLTでは、ソース文書、スタイルシート、結果文書に同じデータモデルを使います。それらはXPathのデータモデルを基本として、少しだけ変更したものです。

・整形式のソースXML文書を読み込んでソースツリーを構築するときは、ルートノードの下にテキストノードはなく、唯一の要素ノードを子として持ちます。また、DOMなどの他の方法でソースツリーを作るときは、ソースツリーに対する制約は結果ツリー同様に緩められます。

・文書スタイルシートのツリーを構築するときは処理命令とコメントノードを無視します。

・結果ツリーでは、ルートノードへの制約が緩められており、子供として要素ノードを含む、任意のノードの系列をもつことができます。これにより、整形式XMLでない出力を作ることができます。

ですので、たぶん、XSLTでは整形式でないようなソースXMLでも処理できそうです[5]。

[1] 『スタイルシート開発の基礎』
[2] アマゾンPODの便利な利用法
[3] XSL Transformations (XSLT) Version 1.0
[4] XML Path Language (XPath) Version 1.0
[5] Extensible Markup Language (XML) 1.0 (Fifth Edition) 2 Documents
[6] 余談です。『スタイルシート開発の基礎』の著者(神様)に、Michael Kayさんの本にそんなことが書いてある、と話しましたら、仕様書のどこに書いてあるかを示せ! と言われました。それは、3.1 Root Node Childrenの二つ目の段落の後半のセンテンスにあります。

次回:
XSLTを学ぶ(2)ノードツリーとノードの親子、子孫関係

構造化文書とは何か?

新年、明けましておめでとうございます。

弊社では、2016年の課題のひとつとして、構造化文書の普及促進に重点的に取り組む予定です。構造化文書とは、文書の構造をマークアップした文書のことです。

では、文書の構造とはなんでしょうか? どんな意義があるのでしょうか?

文書構造の一つに、階層構造があります。2015年の暮れにJEPAのebookpediaで「階層構造とは」という用語解説が発表されました。この用語解説は人気抜群なのだそうです。

〇ebookpedia「階層構造とは」

主に電子書籍の階層構造について説明したものですが、簡単に整理すると次のようになるでしょう。

1.階層構造とは、章・節・項のような、つまり、大見出し、中見出し、小見出しのような見出しをつけること

2.階層構造は、XHTMLの<section>, <h1>~<h6>のようなタグで付ける。

3.階層構造の見出しによって、文章の持つ意味や重要度を差別化でき、読み手に意味の重要度が伝わる。また、目次を作ることができる。

4.タグに対して、スタイルシート(CSS)で重み付けと視覚的表現を紐づける。CSSを書き換えることで、見出しの色やフォントを切り替えられる。

この用語説明で、階層構造とはなにか? どんな意義があるかが大雑把に分かります。電子書籍のような簡単な出版物では、この程度の理解で十分かもしれません。しかし、電子書籍についていえば、eboookpediaでも少し触れられていますが、階層構造のような簡単な概念さえ、様々な見解があって必ずしも完全に合意されているわけではないようです。

文書の著者・編集者・制作者は、何らかの構造を念頭に置いているでしょう。これを暗黙ではなくて、明示的なルールでマークアップしたときに、構造化文書となります。タグはマークアップ手段のひとつです。

ところで、階層化以外の構造もあります。例えば、DITA(Darwin Information Architecture)では、技術文書を対象にして、構造についてもっと高度に定義しています。高度な構造は作成に手間がかかりますが、それなりの効果もあります。DITAにおける構造については、後日別途検討する予定です。

続きは:
1. あらゆる文書には構造がある?
2. 多くの文書は目的に応じた構造を持つ。その構造を明示化したのが構造化文書

関連ブログ(CASブログ)
CAS記法のマークアップがなぜ必要なのかー図版とキャプションの例
コンテンツの構造化とは何か? 構造化の目的、手段は? Word文書のスタイル付けとマークアップの関係

[参考資料](用語解説)
1.マークアップとは
2.DITA