タグ別アーカイブ : PDF

【終了しました】弊社オンラインショップにて歳末大感謝セール開催中!

12月も半ばとなりました。
通販サイトの年末商戦に宅配業者が悲鳴を上げているというニュースはここ数年毎年見ている気もします。今年は直接会わない方へ向けてのお歳暮などでさらに大変かもしれません。

アンテナハウスのソフトウェアの場合、インターネットから注文をするのであれば、アンテナハウスオンラインショップからダウンロード版をご購入いただくことも可能です。在庫切れを気にしなくてよいというのもダウンロード版の利点です。

アンテナハウスオンラインショップ 歳末大感謝セール

このブログのバナーでも表示されているかもしれませんが、現在「歳末大感謝セール」と題して瞬簡PDFファミリーのダウンロード版が特価となっています。12月25日14時までのセールです。終了しました。

それぞれのソフトがセール価格となっていますが、たとえば『瞬簡PDF 変換』と『瞬簡PDF 編集』を組み合わせることで、OCRで透明テキストを一括で付加し、その訂正まで行えます。

https://www.antenna.co.jp/pdftooffice/function03.html#srt02

次のURLから、申請書類PDFなどへの書き込みに活躍する『瞬簡PDF 書けまっせ』の機能を一覧できます。

https://www.antenna.co.jp/kpd/funclist.html

次のURLから、瞬簡PDFファミリー製品の、機能ごとの比較表もご覧いただけます。

https://www.antenna.co.jp/product/pdf_comparison.html

ドキュメント技術関連の日本語動画はあまりない?

つい先日、有名なLaTeX入門書の第8版が発売されました*1。私は6版の頃から購入していますが、新しい項目の追加もされており、旧版をお持ちの方もおススメです*2。使い方なども含めて時代に合わせた内容のアップデートの大切さも教えてくれる書籍です。基礎的、原理的な内容を扱ったものではないのに20年近く内容が更新されながら販売され続けている書籍というのはかなりすごいことだと思います。

ところで2000年頃は結構出版されていたXMLについての書籍はほとんど見なくなりました。「XMLが廃れた」というよりは「XMLを手書きする機会が減った」あるいは「基本を覚えた後はIDEのガイドに従うだけで済むくらいにツールが成熟した」ということの結果かもしれません。

いやいや「現代はみんな動画で情報を得ようとしているのかも」とYouTubeで「XML」を検索してみると、そこそこの件数が表示されました。しかし「PDF」で調べたときに比べるとかなり少ないようです。PDFはPDFで単語が検索にひっかかるものの話題がかなり異なる「ノイズ」が結構あったので軽く調べた程度ではちゃんとした数字を出すのは厳しいですが*3、PDFと比べ世間的な関心はやはり薄いのかもしれませんね。ちなみに「XSL」「XSL-FO」になると英語での結果を含めてもかなり限られる、というより日本語の動画がほとんどありません。

そんなPDFにしても、「このツールを使えばできます!」という内容がほとんどになり、「なぜかPDFという形式を使わなきゃいけないみたいだけど、なぜPDFがいいんだろう」といった技術的な話題を取り扱っているものはあまり見ません。「明日提出しなければいけない書類を前にそんな内容は観ていられない」というのはそうかもしれませんが、今の情勢は、そんな間に合わせの状況を変える転換点にきているのかもしれません。とりあえずの問題を解決するための「ツールの使い方」も大切ですが、より効率的に、根本的に問題を解決するためには技術そのものへの理解も重要です。「日本語で弊社の得意とするドキュメント関連の技術をしっかり動画で解説してほしい」というご要望がありましたら、ぜひ声をお寄せいただければ幸いです。

弊社PDF関連製品の使い方やウェビナーの過去回をまとめた動画を公開しています。

*1ですが、最初に付録の参考書籍一覧を見たとき「こんなのもう手に入らないだろう」と思っていたのに、気が付けば6割近くを所有していたり。一方で10年前にはフリーで配布されていた組版ソフトウェアの情報の方が手に入りづらかったりして歯がゆく思う今日この頃。

  1. *1 『[改訂第8版]LaTeX2ε美文書作成入門』(奥村晴彦,黒木裕介 著, 技術評論社, 2020-11-14, ISBN 978-4-297-11712-2)
  2. *2 TeXの始まりから数えれば40年くらい歴史あるものでも「枯れた」とは限らないのがソフトウェア(LaTeXについては今年かなりの大変更が入ったりしています)
  3. *3 LaTeXはLaTeXで組版と関係ないLatexが結構混じってくるので大変検索しづらいです

P.S. 記事を書いた後「記事タイトルはこれでいいんだろうか」と悩み、DITAやS1000D、SphinxやPerlDocなども検索してみましたが、タイトルは変えなくて良さそうでした。

「PDFは編集できない」って? ちょっとちょっと政府CIOの皆さん、その認識はぜひ改めていただきたい。

菅内閣目玉の政策として「デジタル庁」があります。デジタル庁は現在準備室が発足し、来年(2021年)の発足を予定しているようです。IT技術をつかってデジタル化を図るには、共通化やポータル化が必須なので、強い権限をもつデジタル庁を作るのは適切な考え方でしょう。

ところで、これに関連し、政府CIOポータルに「デジタル・ガバメント実行計画」というページがあります。

デジタル・ガバメント実行計画

全文(PDF)

この資料、PDFファイルで全215ページなのですが、検索すると、その中にPDFについて言及している箇所が2か所あります。

◎1か所目(p.56)

「(d)編集可能な電子ファイルによる申請書様式の提供
利用者が行政手続を行う際の利便性向上のため、当該行政手続に係る情報をWebサイト等で容易に入手でき、かつ、Webサイトの入力フォームを利用して直接申請書の作成を可能とする又は申請書様式の電子ファイルをPDF などの編集不可な形式ではなく、編集可能な形式の電子ファイルで入手可能とする。」

◎2か所目(p.75)

「また、業務上使用する文書等について、デジタルデータで作成された文書であっても、文書交換を行う際には紙媒体や PDFファイルなどの編集等が困難な形で流通しているなど、業務が非効率になっている場合がある。また、各府省のWebサイトで公開されている資料についても、編集が不可な状態のものや、資料のステータス(日付、会議名、担当府省等)が不明なものも散見される。」

これを読むと、PDFは編集不可、あるいは編集困難とされています。どうやら、デジタル政府では、申請書などはPDFファイルで用紙を配布するのはやめて、Webサイトの入力フォームを推薦したいようです。

では、実際のところ、PDFファイルは編集できない・編集困難なのでしょうか? 次のような事情を考えると、「デジタル・ガバメント実行計画」のPDFファイルに関する記述は、現在では適切ではないと思われます。

PDFは編集できるという事実
第一に、現在市場には、非常に多様なPDF編集ソフトが流通しています。有名どころは某A社製品ですが、アンテナハウスでも『瞬簡PDF編集』を販売しています。

第二に、アンテナハウスの『瞬簡PDF 書けまっせ』のように、PDFを紙のように見立てて、PDFファイルの上に文字を重ねて書きこむ(追記)ソフトも増えています。

第三に、PDFで申請用紙を作る形式として、PDFフォームがあります。PDFフォームを使えば、特別なツールを使わなくても、PDFフォームに文字を書きこむことができます。「PDFフォームとはなにか? 申請のデジタル化にPDFフォームの活用を期待する」

Webフォームも良いですが、Webフォームはサーバーサイドの用意も必要であり、大きな開発工数や保守工数がかかります。また、専門家でないと多様なフォームを作るのは難しいので、非常に多岐にわたる形式のフォームを誰でも簡単に作成して配布するのはWebフォームでは難しいと考えられます。PDFをもっと活用する方が効率的でしょう。

ぜひ、政府CIOの方々には認識を改めていただきたいものです。


shunkan pdf henshuu
shunkan pdf kakemasse
tyotto hitoiki antenna house webinar

fo:bookmarkというマークアップから考えるしおり

『岩波国語辞典第八版』*1によれば、「しおり(しをり)」には2つの意味があります。

1. 本の読みかけのところに挟んで目印とするもの 2. 初めての人などにわかりよく説明した本。手引き

岩波国語辞典第八版

「目次」は次のように記されています。

(書物の)内容の題目を、書かれている順に並べて記したもの

岩波国語辞典第八版

しおりについて、1の意味では、読み手側が設定するものという印象が強いですね。ちなみに岩波国語辞典だとブックマークはWebブラウザのブックマーク(お気に入り)機能についての言及となっています。

さて、XML組版の仕様であるXSL1.1仕様にはしおりを作成するための機能fo:bookmark、fo:bookmark-title、fo:bookmark-treeが存在します。1.1の仕様に1.0との差異が記載されているのですぐにわかりますが、実は1.0のときには存在しなかった機能です*2。

『XSL-FOの基礎 第2版』*3にしおりのFOについての解説があります。また、Antenna House XSL Formatterの*4サンプルFOのページ*5からしおりの設定されたPDFを確認できます。

<fo:layout-master-set>
    …略…
  </fo:layout-master-set>
  <fo:bookmark-tree>
    <fo:bookmark internal-destination="MARK001">
      <fo:bookmark-title font-weight="bold">
    目次</fo:bookmark-title>
    </fo:bookmark>
    <fo:bookmark internal-destination="MARK002"
                 starting-state="hide">
      <fo:bookmark-title>第1章</fo:bookmark-title>
      <fo:bookmark internal-destination="MARK003">
        <fo:bookmark-title>1.1</fo:bookmark-title>
      </fo:bookmark>
     ...
     </fo:bookmark-tree>
     ...
    <fo:page-sequence ...>
      <fo:block font-size="2em" font-weight="bold" space-after="5mm" id="MARK001">Bookmark sample-1</fo:block>
        <fo:block font-size="1.5em" font-weight="bold" id="MARK002">Lorem Ipsum</fo:block>
          <fo:block space-before="4mm" margin-left="2em" line-height="1.4">
         <fo:block keep-with-next="always" font-weight="bold" id="MARK003">Lorem ipsum dolor sit amet</fo:block>
            <fo:block>...</fo:block>
        </fo:block>
...
</fo:page-sequence>

ごく簡単に説明すると、fo:rootの子としてしおりのツリーを用意し、その子として、目的のIDやURLなどをプロパティの値に持つしおりfo:bookmarkとしおりの項目名fo:bookmark-titleを記述します。上の例ではfo:blockにそのIDが記述されていますね。ツリー構造ですので、階層も表現できます。

PDFなど、ページドメディアへの出力を意識したマークアップであるXSL-FOの機能として用意されていることから分かる通り、これは文書コンテンツ提供側が用意するしおりです。
XSL-FOは(中間形式にせよ)ページドメディアとしてかなり明示的なマークアップを求めますから「fo:bookmark*」は「この箇所をしおりとする」というはっきりとした意思表示となります。
文書コンテンツ作成者がコンテンツ頒布時に「この部分は読みかけ」というしおりを作ることは稀なことと捉えて良いでしょう。そして、fo:bookmark-titleというマークアップ名から分かる通り、しおりの項目名は長い段落などを記述する箇所でもありません。

目次項目は当然その項の内容を反映しまとめたものになりますから、しおりは多くの場合目次項目と同じ箇所でマークアップされ、対応したPDFビューアーでは「しおりを表示」といった機能でページ表示とは独立して表示できます。
特に数百、数千ページのPDF文書を頻繁に読む機会のある方は頷かれるのではないかと思いますが、紙の文書ではそれこそ「しおり」を挟んで分厚いページの束をまとめてむんずと掴んで目次に戻ったりできますが、PDFビューアー上で毎回目次ページへ戻って目次項目を確認するというのはそこそこ時間がかかります。

個人的には、しおりの重要な点として「ページ外の要素」であることが大きいのではないか、と考えています。目次で「2.3 詳細 200ページ」、文章中に「299ページに詳細」、索引ページに「fo:bookmark…300p」といったページ参照があるのはそれはそれで重要ですが、「本文を読みながら文書(あるいは文書外)の他の箇所への目印へすぐにアクセスできる」機能がしおりといえるのではないでしょうか。そして、XSLでは文書コンテンツ提供側がそれを提供することになります。

ところで、XSL-FOとXSL-FOプロセッサーによる処理ではPDFの作成時にしおりをマークアップすることになるので、すでにPDFとなっているものにしおりを付与することは範囲外です。Antenna House Formatterでは「PDFを画像のように埋め込む」といったことができるので、多少トリッキーな方法で後からしおりを付与することもできなくはありません。しかし専用のソフトウェアがあればもっと分かりやすく、そして効率的にしおりを付与できます。

antenna house webinar pdf bookmark

隔週で火曜に開催している「ちょっと一息 アンテナハウスウェビナー」、11月10日(火)16時からは「そもそも、PDFのしおりとはなにか ~目次と何が違うのか。どう作って活用するか~ 」というテーマでお送りします。この記事を書いているのが担当者でないため、発表内容の詳細はわかりません。しおりってなんなんでしょうね……。この謎を明かすためにも明日のウェビナーは必見です。

参考文献・資料

  1. *1 『岩波国語辞典第八版』(岩波書店, 2019年11月22日第1刷発行, ISBN 978-4-00-080048-8)
  2. *2 https://www.w3.org/TR/xsl11/#change10
  3. *3 https://www.antenna.co.jp/AHF/ahf_publication/data/xsl-fo-v2/201603282131.html『XSL-FO の基礎 第2版 – XML を組版するためのレイアウト仕様』(アンテナハウス株式会社, 2017年3月, ISBN 978-4-900552-48-7)
  4. *4 Antenna House Formatter
  5. *5 https://www.antenna.co.jp/AHF/ahf_samples/sample-fo.html#pdf

ユーザーニーズとウェビナー

先日、家族から「会社から配布された書類に文字を入れて提出しなければいけないらしいが、どうしたらいいのか」と相談されました。
メールに添付されたファイルはPDF。これは弊社の製品を売り込むチャンス!?と思ったものの、「瞬簡PDF 書けまっせ」を売り込んでいる途中でもう一通メールが。こちらはどうやらMicrosoft OfficeのExcelファイルが添付されていたようで、最初のメール添付ファイルは書くべき書類のサンプルだったようです。

売り込みは途中で頓挫したものの、勤務している会社でどういった製品を取り扱っているのか、普段は「なんか難しそうだから聞きたくない」という態度の家族にも紹介できる機会となりました。
とはいえ「それが自分たちの生活や仕事にどう影響するのか」という範囲でしか興味は持ってもらえず、PDFについても「OfficeソフトのファイルやWebページがあればいいじゃないか」という家族の意見を覆すには至りませんでした。

これは逆に考えれば「それが自分たちの生活や仕事にどう影響するのか」「わかりそうな話」であれば興味はある、ともいえます。加えて「素早く」とついていればなおのこと。

さて、アンテナハウスでは「アンテナハウス ウェビナー」を毎月第2火曜、金曜の16時より開催しています。
弊社の製品や技術でどんなことができるのかわかりやすく紹介、解説する試みですが、これは同時に「どんな製品や技術が皆さんの生活や仕事で役立つのか」「どういった事柄と絡めて知りたいのか」「どのくらいのレベルで知りたいのか」といったフィードバックを従来よりも気軽に聞きたいという、皆さんと弊社の双方向のコミニュケーションの試みでもあります。

はこんなセミナーもあります。

ぜひご登録、ご参加いただき「どこがわかりやすかった」「ここを教えてほしかった」など、ご意見をいただければ幸いです。

他にも、「マンガでわかる!! アンテナハウス システム製品利用例シリーズ」という、
ストーリー仕立ての製品利用例のご紹介もしています。

Google Chrome開発者版(86)でタグ付きPDFを出力[8/4修正]

[8/4追記]社内で「Chrome出力ではなくAcrobat Readerの対応外のタグ使用によって表示が壊れている可能性がある」と指摘を受けました。記事内での表現を修正します。

当初の記事タイトルは「タグ付きPDFがGoogle Chromeのデフォルトに?」だったのですが、現状としては「今後Google Chromeでタグ付きPDF出力が可能になるかもしれない」あたりのようです。

今回使用した環境は次になります。

  • Windows 10 Home 1909
  • Google Chrome バージョン: 86.0.4221.0(Official Build)canary (64 ビット)
  • Acrobat Reader DC – Japansese (20.009.20074)
  • 検証に使用したページ*: https://www.w3.org/TR/xsl11/

2020年8月リリースのGoogle Chrome 85から、タグ付きPDFの出力がサポートされます[1]。関連する情報発信自体は以前からあったようですが、実際にリリースされるこのタイミングで俄かに活気づいているようです。活気づいてますよね?

早速Google Chromeをサイトからダウンロードしてみましたが、バージョンを確認すると2020年8月3日時点では84のようです。Google ChromeにはCanaryバージョンがあるのでこちらをダウンロード。試験運用版ですので、同様に検証される方はくれぐれも自己責任でお願いします。(84でもExperimentalの設定として「Export Tagged PDF」を有効化できます。)

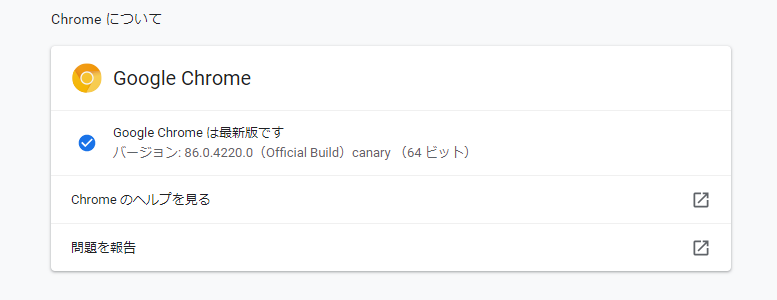
バージョンを確認。86……86ですね。85ではありませんが、検証には問題ないでしょう†。

† この後Chrome 84でのtagged PDF出力も確認しましたが、同様の結果になりました。

タグ付きPDFとは

ざっくりとまとめると「タグ付きPDFは、内部に文書構造を指定するタグを付与したPDFのこと」になります。
通常PDFは印刷物のデジタル表現、つまり視覚的な表現として文書構造が見られればよいわけですが、
PDF内部のデータを別の目的で使うときにこの情報だけでは不足することがあります。
別の目的としては、データの読み上げ、PDFから他形式への再変換などがあります。

また、PDFをHTMLのようにリフローで表示したいときにも、タグを用いることで文書の表示順序などを壊さないようにできます。
「HTMLのように」と書きましたが、このタグ付きPDFで設定できるタグの多くはHTMLでのタグと類似したものになります。

概要は[2][3]、詳細は[4][5]をご覧ください。

新ビューアは今のところリフロー表示に対応していないらしい

Canaryだと、PDF出力オプションの他に「PDF Viewer Update」オプションがあるんですね。

chrome://flags/#pdf-viewer-update

これを有効化すると、84ではExperimentalのオプションである「PDF Two-up View」もついでに使えるようになります。

ウインドウ画面と表示をフィットさせる場合に上下と左右どちらを優先するか、回転表示、PDF注釈の表示のオンオフ、アウトライン表示など、色々改善がされていることがわかります。とはいえ、全体的なPDFの表示機能についてはまだまだ頑張ってほしいところです。

さて、タグ付きPDF対応と聞いて真っ先に期待してしまうであろうリフロー表示ですが、とりあえず86の新ビューアではできないようです。
「タグ付きPDFの出力」と「PDFのリフロー表示」は重なる部分もあるものの別の話なので、そういうこともありますね。
今回の新バージョンについて、ChromiumのブログにChrome Accessibilityのリーダーからコメントがあります。improving Chrome’s built-in PDF reader to better consume tagged PDFsとあるので、それなりに可能性はあるのではないでしょうか。
> While this is an important milestone, we’re not done. Future work includes both improving the quality of generated tagged PDFs, and also improving Chrome’s built-in PDF reader to better consume tagged PDFs.

タグ付きPDFをChromeで出力する

本題のタグ付きPDF出力です。Experimentalな設定で次を指定するとタグ付きPDFが出力できるようになるとあります。

chrome://flags/#export-tagged-pdf

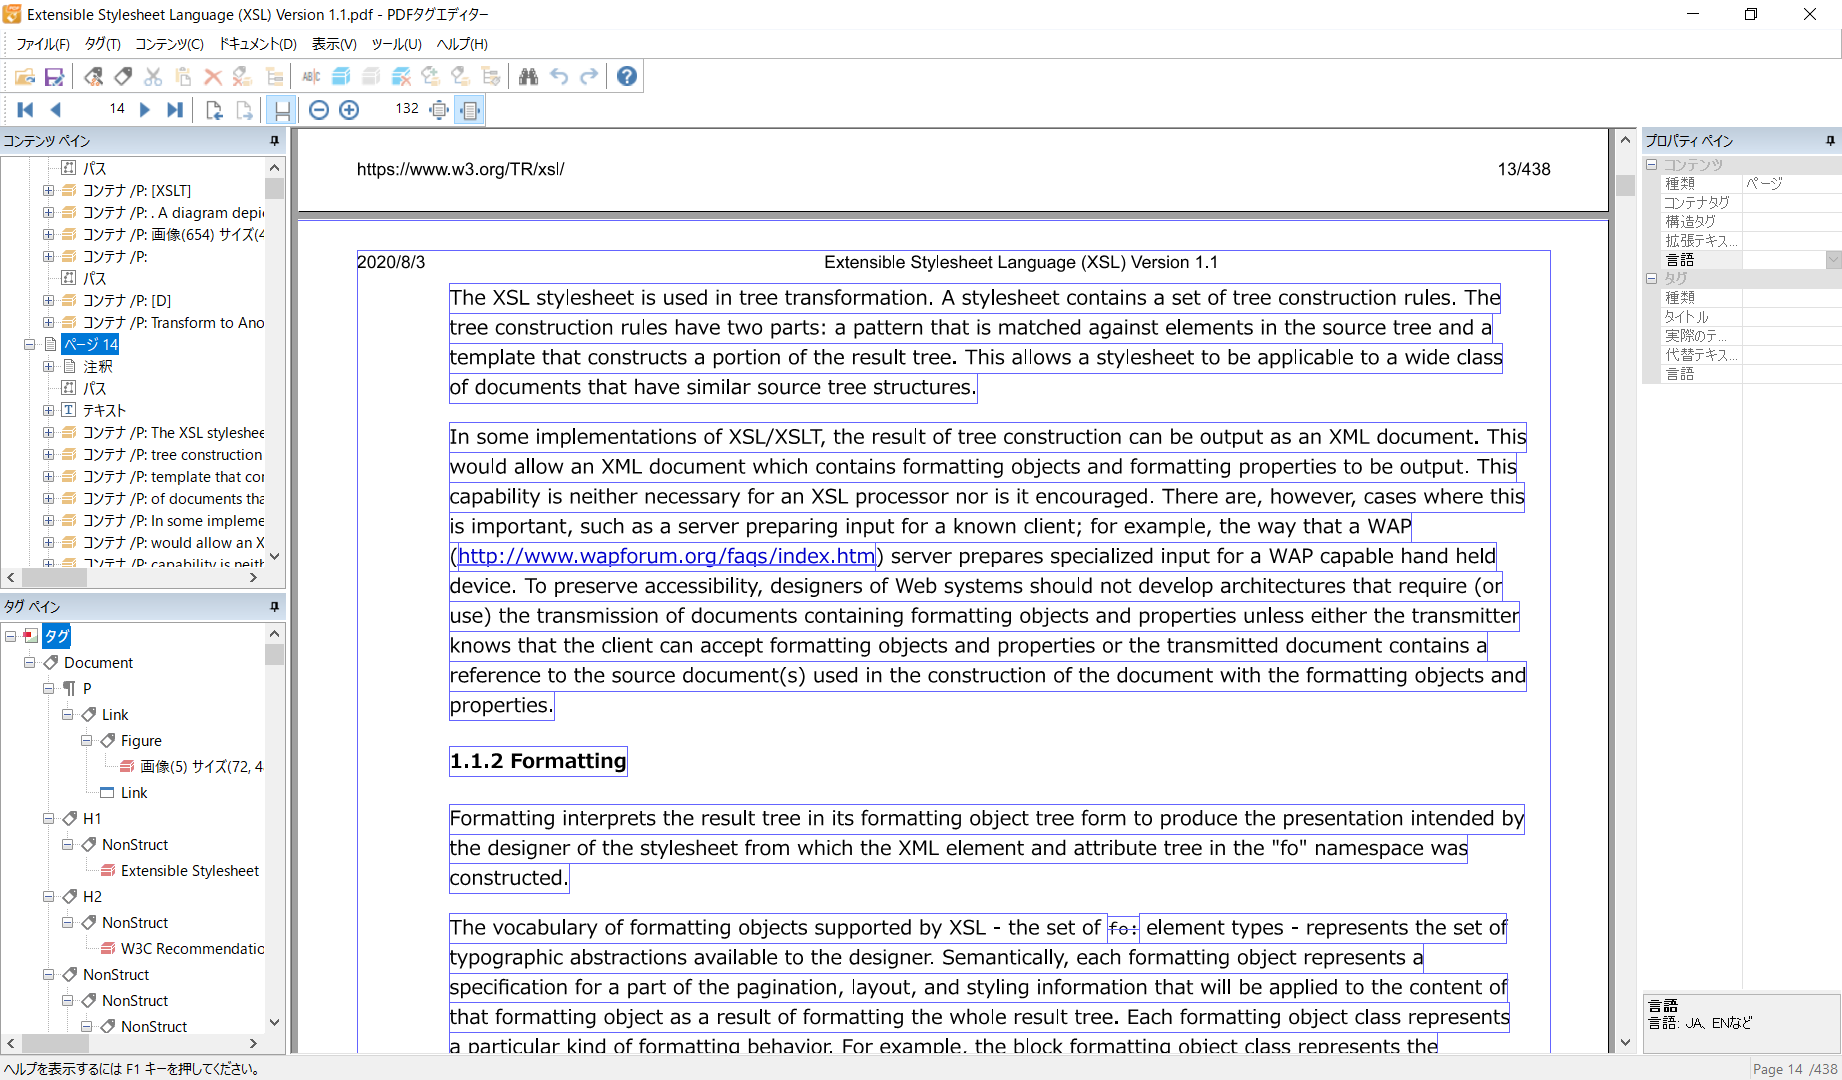
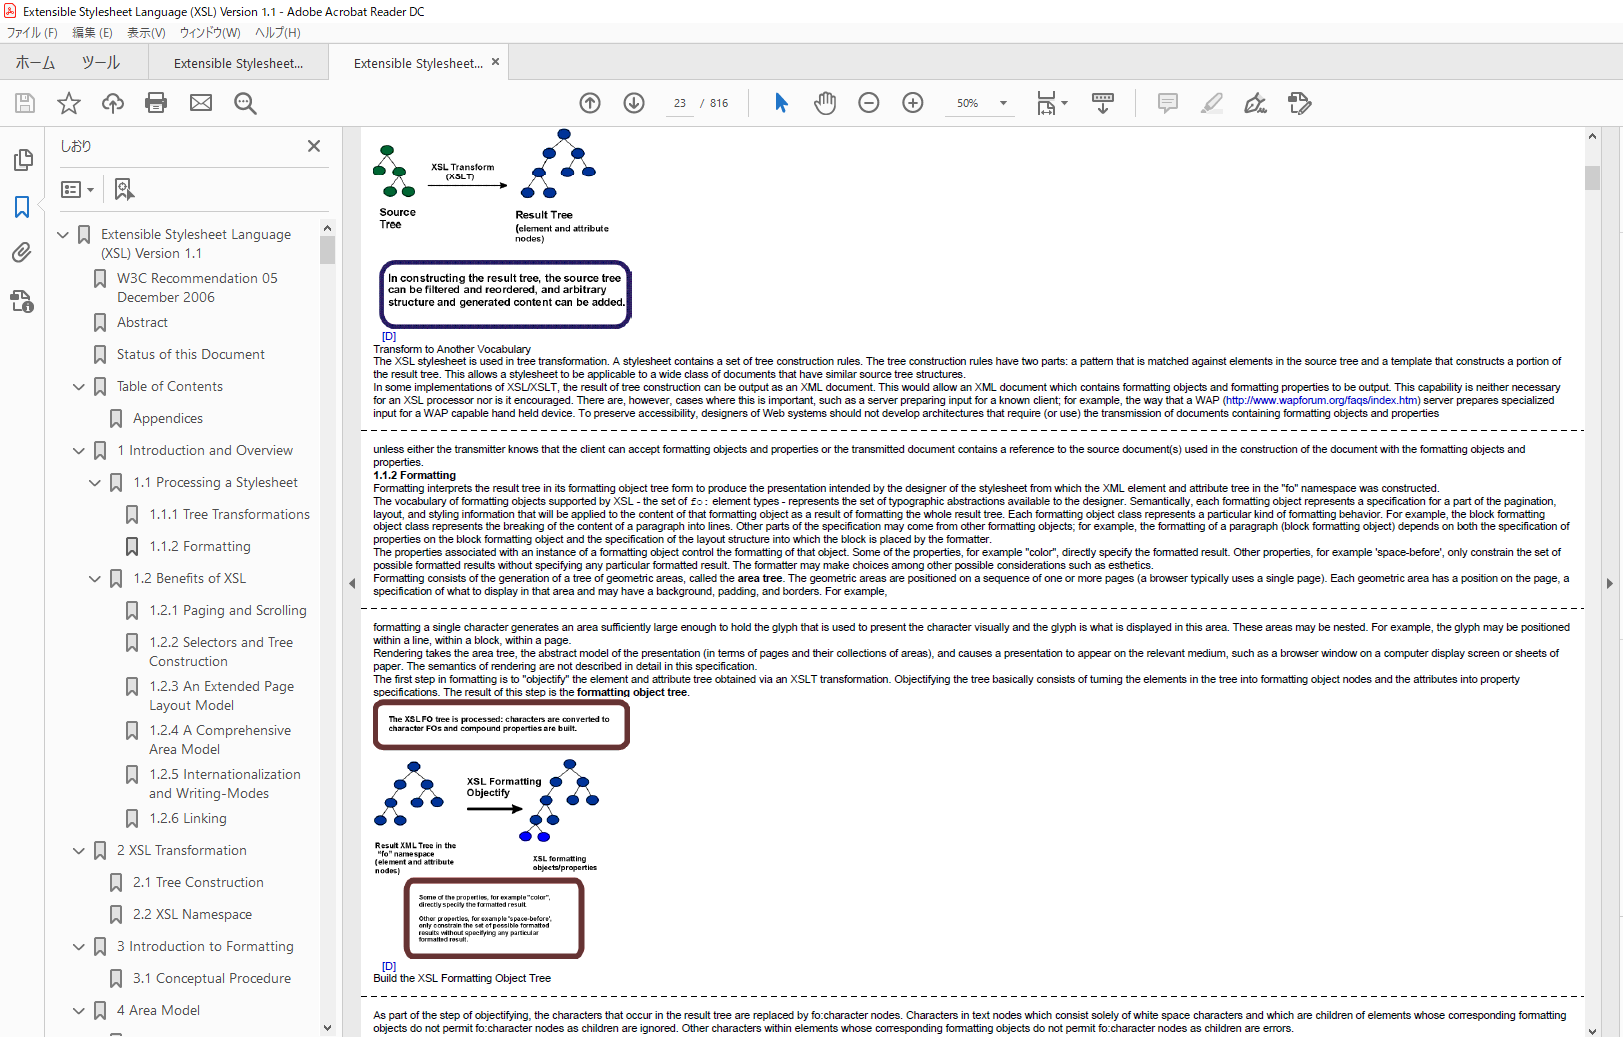
では、PDFを出力してみます。*のページを「PDFで保存」します。さて、本来はこれをAcrobat Readerで開いてみて「おおー」となる予定だったのですが、「表示」「折り返し」を有効にしたAcrobat Readerでのリフロー表示がうまくいってないようです。

W3Cのページはあまり変なマークアップのHTMLはないはずです。タグ付きPDFは検証した日時でのGoogle ChromeとしてはExperimentalな機能なので、こちらが原因でしょうか。タグ付きPDFとリフロー表示についてはAcrobat Readerの対応状況も関連するので、Chromeの出力が原因ではないかもしれないとの指摘をいただきました。Google Chromeには自分の出力の正しさを証明するためにもPDFリフロー表示に対応してほしいですね。
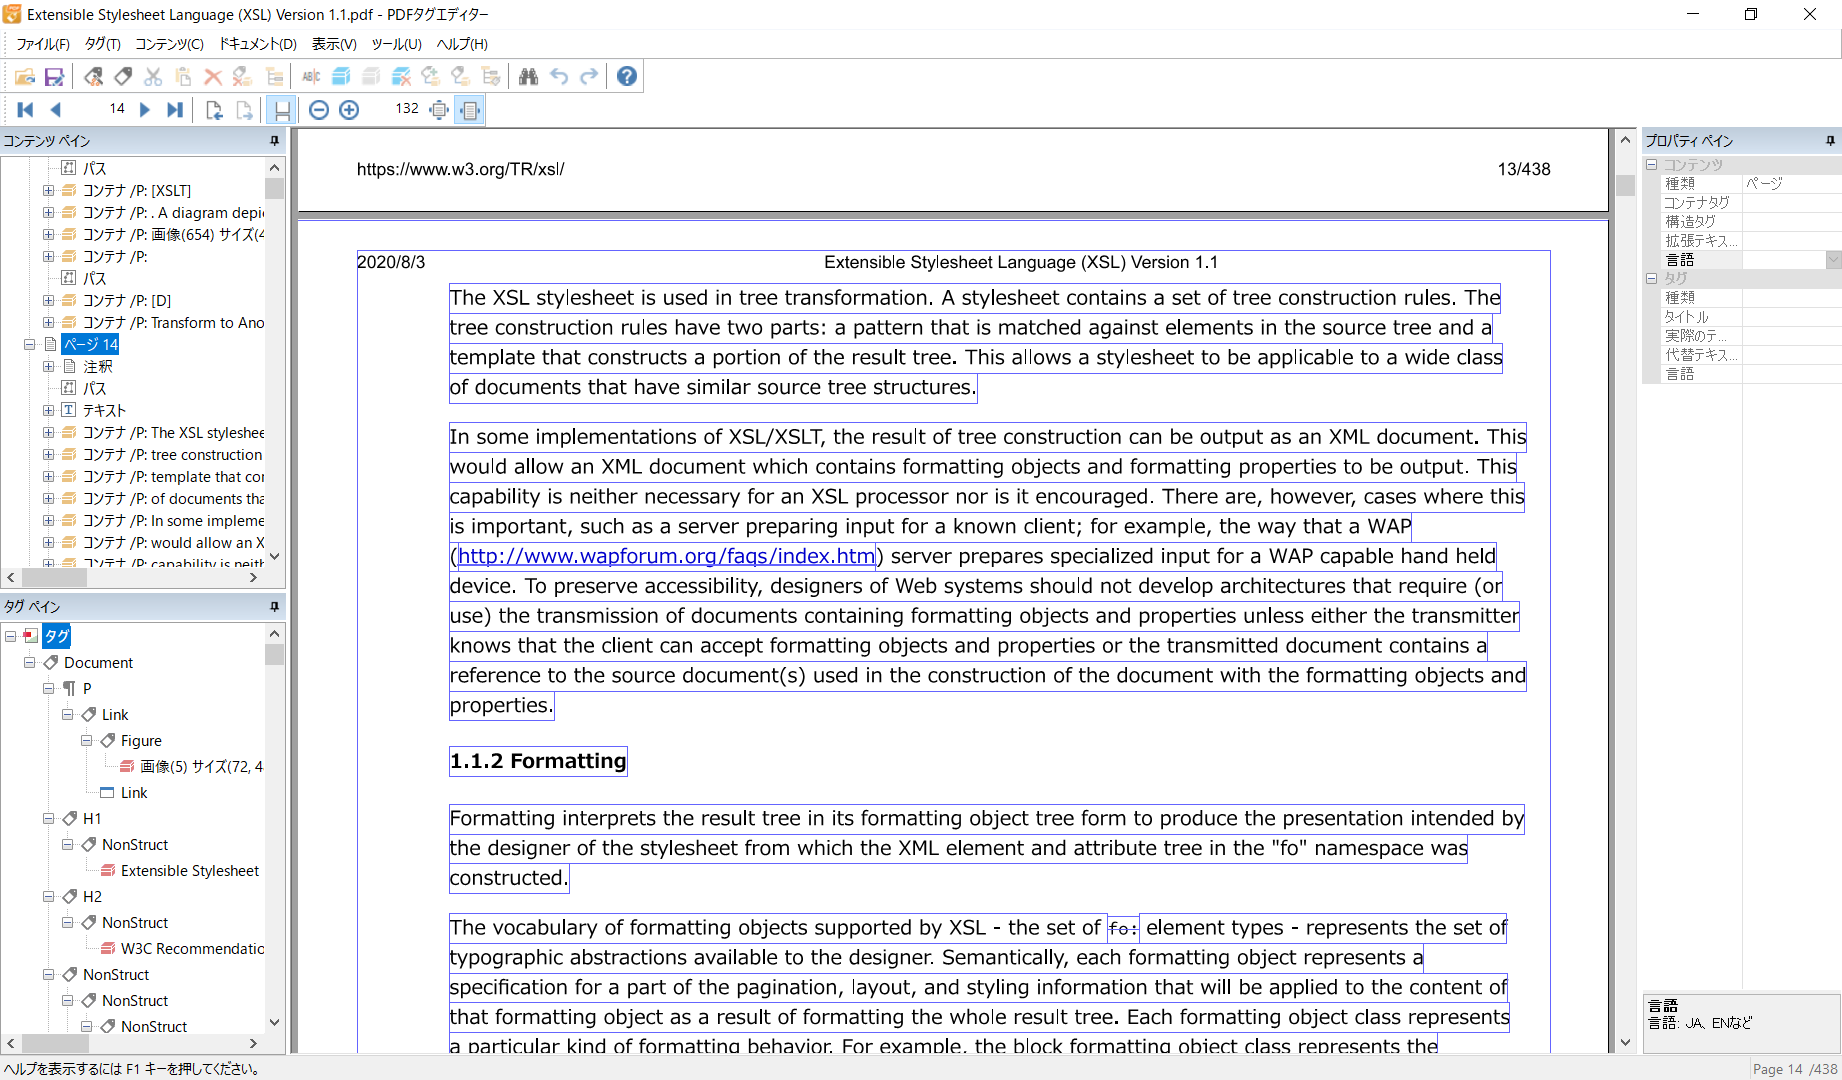
PDFの内部を確認したい方は、アンテナハウスのデスクトップ製品『
瞬簡PDF 編集 9
』[6]付属の『タグ編集ツール PDFタグエディターVer.2』を使うとよいかもしれません。

他に数件確認してみましたが、ページが上のように壊れることはないものの、「いきなり何もかも上手く出力できる」とはいかないようです。Experimentalな機能なので詳細な検証をすることを避けました。

ちなみに、Chromeでのタグ付きでないPDF出力をAcrobat Readerの折り返し表示したときは、とりあえずは表示されています。

ちなみに、同じWebサイトをAntenna House Formatter V7.0 MR3でタグ付きPDFを出力した場合、折り返し表示でも問題はないようです(フォントサイズや余白、分割アルゴリズムの違いなどがあるので同じ条件にはなっていません。)。

ChromeでのHTMLとタグ付きPDFの補足資料

Chromiumのタグ付きPDF機能開発におけるデザイン資料[7]によればこれはマークアップを元にタグを付与するものなので(AIが何もかもやってくれるような話ではない)、求められるタグを出力できるかはページ製作者次第です。Chromeの開発過程で実際にはどうなったかは確認していませんが(資料中のメーリスやバグトラッカーを確認していけばよさそうです)、DOMツリーと描画用ツリー、そしてARIA属性などを基にした「Accessibility tree」を利用するデザインのようです。


The accessibility tree computed in Blink is another good possibility. The accessibility tree is derived from the DOM and the Layout Tree and also takes accessibility attributes such as ARIA attributes into account.
Chromium Tagged PDF Export Design Doc

We think the accessibility tree is the best fit and that’s the design proposed here.
Chromium Tagged PDF Export Design Doc

つまり出力が完璧だったとして、現在のところ多くのWebページについて実用的かと言われれば疑問の残るところ。残念ながら、ページによってはむしろ不要なノイズだらけになってしまうでしょう。[7]に次のようにありますが、こういった機能を機にアクセシブルなWebページを作ろうという気運が再燃したりすれば幸いです。

正常に出力されるページもあるかもしれませんが、現在Experimentalとある機能ですので、今回はここまでとします。

タグ付きPDFにご興味を持たれた方は、アンテナハウスのPDF製品を是非チェックしてみてください。


if you visit a web page that’s compliant with WCAG accessibility guidelines, then export it as PDF, then open that PDF in Chrome, the PDF in Chrome should have the same level of accessibility, modulo the limitations of a PDF file.Chromium Tagged PDF Export Design Doc

  1. [1] Using Chrome to generate more accessible PDFs – Chromium Blog
  2. [2] タグ付きPDFとはどんなもの
  3. [3] PDFのリフロー表示。タグ付きPDFとタグの付いていないPDFの比較。
  4. [4] 『タグ付きPDF 仕組と制作方法解説』
  5. [5] 『PDFインフラストラクチャ解説』
  6. [6] かんたん操作でPDFを自由自在に編集 瞬簡PDF 編集 9
  7. [7] Chrome Tagged PDF Export – Authors: dmazzoni[at]chromium.org
    November 2019


CommonMark文書をXSL-FO経由でPDFへ変換する

前回、cmark[1]でCommonMark[2]のASTをXML形式で得られることを確認しました。

記事中で登場するコードの動作についての保証はできかねます*1。ご了承ください。

今回の記事で使用した環境は次になります。

文書はその目的に適した構造を持ち、組版では多くの場合その構造に沿ってマークアップを行うでしょう[3]。
Markdownはそれらを放棄しているために、文書として組版するためには不足するものを補う必要があります*2。基本的には、「レポート」であるならレポートの見た目になるよう、Markdown文書とレポートの対応関係を用意する必要があるということです。例えば「<heading level="1">のテキストをレポートのタイトルとする」として、「レポートタイトルはフォントサイズは本文の2倍、中央寄せ、前後のアキは……」とスタイルを用意していきます。書籍を組むのであれば目次や索引などが補う対象となります。

記法の数が比較的少ないCommonMarkとはいえ、すべての対応関係について記述するのは労力が大きいため、一部のみとします。また、前回言及した「Markdown + XSL → PDF」[4]の記事ではリンク記法を応用して脚注記法を用意していますが、処理が複雑化しますのでこういった応用もしません。

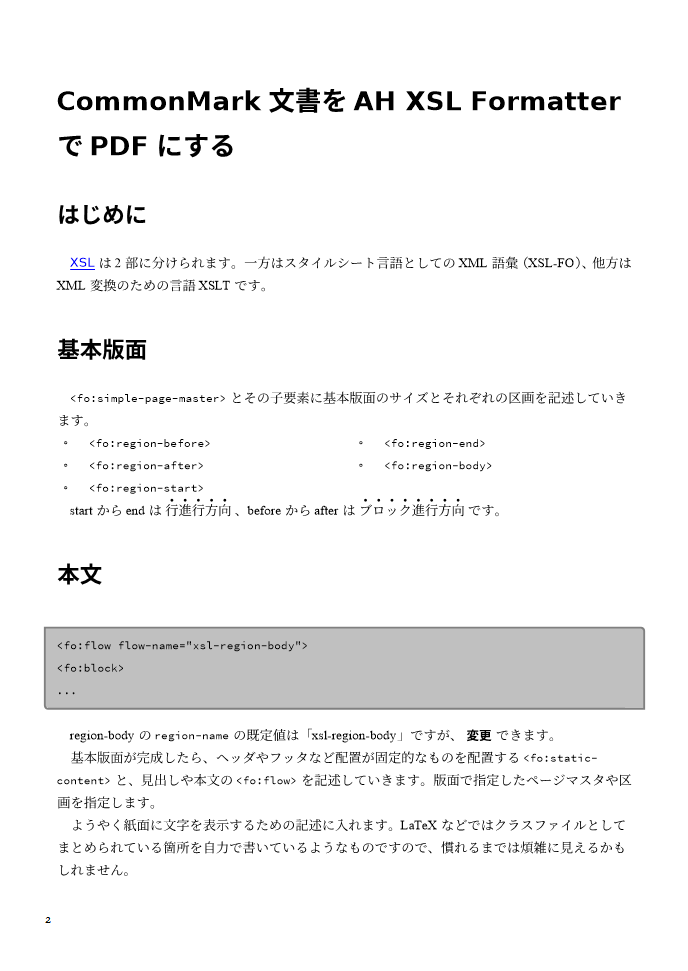
変換するCommonMark文書

# CommonMark文書をAH XSL FormatterでPDFにする

## はじめに

[XSL](https://www.w3.org/TR/xsl/)は2部に分けられます。一方はスタイルシート言語としてのXML語彙(XSL-FO)、他方はXML変換のための言語XSLTです。

## 基本版面

`<fo:simple-page-master>`とその子要素に基本版面のサイズとそれぞれの区画を記述していきます。

* `<fo:region-before>`
* `<fo:region-after>`
* `<fo:region-start>`
* `<fo:region-end>`
* `<fo:region-body>`


startからendは*行進行方向*、beforeからafterは*ブロック進行方向*です。

## 本文

```xml
<fo:flow flow-name="xsl-region-body">
    <fo:block>
        ...
```

region-bodyの`region-name`の既定値は「xsl-region-body」ですが、**変更**できます。

基本版面が完成したら、ヘッダやフッタなど配置が固定的なものを配置する`<fo:static-content>`と、
見出しや本文の`<fo:flow>`を記述していきます。版面で指定したページマスタや区画を指定します。

ようやく紙面に文字を表示するための記述に入れます。LaTeXなどではクラスファイルとしてまとめられている箇所を自力で書いているようなものですので、慣れるまでは煩雑に見えるかもしれません。

XMLへの変換

このCommonMark文書をPDFに変換します。
cmarkによるCommonMark文書のXML変換はコマンドライン操作になります。標準出力に出力されるため、出力結果をファイルに書き込んでいます。変換結果のXMLで文字化けがしていたら、コマンドラインの文字コード設定などが関係しているかもしれません。

> cmark.exe doc.md -t XML > result.xml 

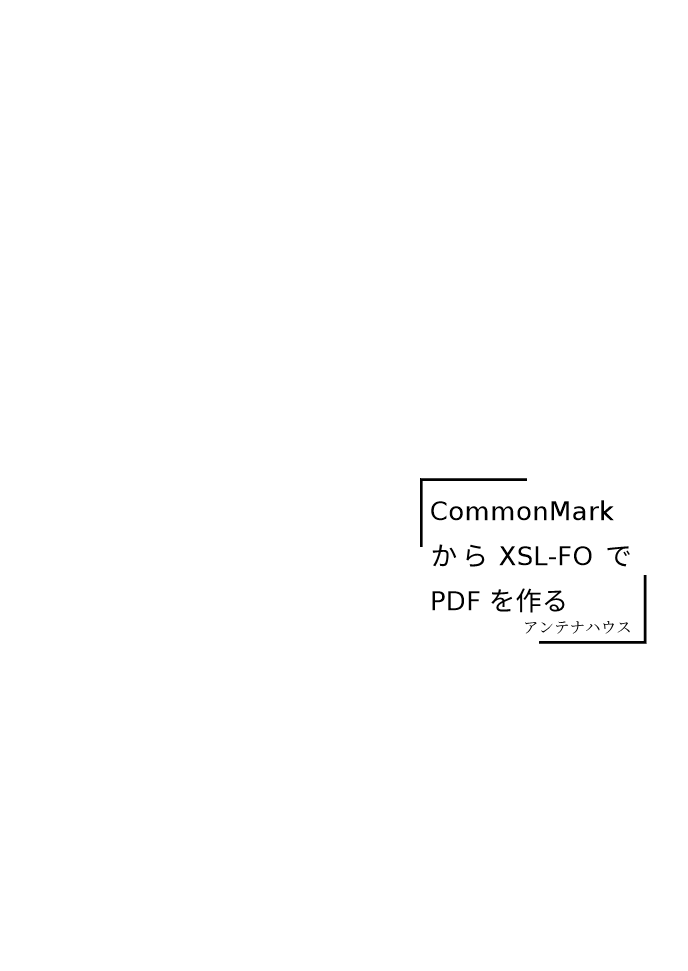
このXMLをXSLTで変換し、得られたFOをAntenna House XSL FormatterでPDFへと変換します。先に結果を見てみましょう。

PDF出力結果


源ノ明朝、源ノ角ゴシックを使用したPDFが出力されています。欧文はTimes New RomanとDeja Vu Sansです。

XSLTの抜粋

AH Formatterではソフトウェア側の設定をあまり弄らずともOpenTypeフォントを使用できます。

<!-- XSLT -->
<xsl:attribute-set name="mainfont">
 <xsl:attribute name="font-family">Times New Roman, 源ノ明朝</xsl:attribute>
 <xsl:attribute name="font-size">14q</xsl:attribute>
 <xsl:attribute name="line-height">1.7</xsl:attribute>
</xsl:attribute-set>

<xsl:template match="/">に<fo:root>を置きます。


<xsl:template match="/">
 <xsl:variable name="varAuthor" select="'アンテナハウス'" />
 <xsl:variable name="varTitle"><xsl:text>CommonMarkからXSL-FOでPDFを作る</xsl:text>
</xsl:variable>
 <xsl:variable name="varMainPageName" select="'main'" />
 
 <fo:root xsl:use-attribute-sets="attsRoot">
 <!-- 基本版面 -->
 <xsl:call-template name="layoutMasterSet"> 
 <xsl:with-param name="mainPageName" select="$varMainPageName" />
 </xsl:call-template>
 <!-- 表紙 -->
 <xsl:call-template name="coverPage">
 <xsl:with-param name="mainPageName" select="$varMainPageName" />
 <xsl:with-param name="author" select="$varAuthor"/>
 <xsl:with-param name="title" select="$varTitle"/>
 </xsl:call-template>
 
 <!-- 文書内容 -->
 <fo:page-sequence master-reference="{$varMainPageName}"
 xsl:use-attribute-sets="attsPageSequence">
 <xsl:apply-templates />
 </fo:page-sequence>
 </fo:root>
</xsl:template>

<xsl:template match="md:document">

 <xsl:call-template name="header">
 <xsl:call-template name="footer" />
 <fo:flow flow-name="xsl-region-body">
 <xsl:apply-templates />
 </fo:flow>
</xsl:template>

基本版面についてはMarkdown側で干渉するところは特にないので名前付きテンプレートとして省略しました*3。coverPageテンプレートで本文とは別に表紙を作っています。
著者情報を「レベル1見出しの直後の段落を著者名にする」といった形でMarkdown側で記述するようにもできるでしょうが、
やはり「Markdownでは記述しない箇所を決める」という割り切りがある程度の単純さを保つために必要に思えます。

ブロックの例を見てみましょう。

<xsl:attribute-set name="attsCode">
 <xsl:attribute name="font-family">Source Code Pro, 源ノ角ゴシック Code JP, monospace</xsl:attribute>
 <xsl:attribute name="font-size">12q</xsl:attribute>
 <xsl:attribute name="xml:space">preserve</xsl:attribute>
</xsl:attribute-set>

<xsl:attribute-set name="attsCodeBlock" use-attribute-sets="attsCode">
 <xsl:attribute name="linefeed-treatment">preserve</xsl:attribute>
 <xsl:attribute name="axf:border-bottom-left-radius">3pt</xsl:attribute>
 <xsl:attribute name="axf:border-top-right-radius">3pt</xsl:attribute>
 <xsl:attribute name="border">solid 1.5pt gray</xsl:attribute>
 <xsl:attribute name="background-color">silver</xsl:attribute>
 <xsl:attribute name="padding">3mm</xsl:attribute>
 <xsl:attribute name="space-before">4mm</xsl:attribute>
 <xsl:attribute name="space-after">4mm</xsl:attribute>
</xsl:attribute-set>

<xsl:template match="md:code_block">
 <fo:block xsl:use-attribute-sets="attsCodeBlock">
 <xsl:apply-templates />
 </fo:block>
</xsl:template>

コードブロックです。CommonMarkのASTにはinfoとして最初の行の```xml、「xml」が格納されていますが、
1からシンタックスハイライトを行うのはつらいので、背景色やボーダー、等幅フォントを指定しています。< xsl:templatye match="md:code_block">の箇所はかなりシンプルにできていますね。

<xsl:attribute-set name="attsListBlock">
 <xsl:attribute name="space-before">1rem</xsl:attribute>
 <xsl:attribute name="space-after">1.4rem</xsl:attribute>
 <xsl:attribute name="provisional-label-separation">2mm</xsl:attribute>
 <xsl:attribute name="provisional-distance-between-starts">5mm</xsl:attribute>
</xsl:attribute-set>

<xsl:template match="md:item">
 <xsl:variable name="type" select="../@type" />
 
 <fo:list-item xsl:use-attribute-sets="attsItem">
 <fo:list-item-label end-indent="label-end()">
 <fo:block text-align="end">
 <xsl:attribute name="axf:number-transform">
 <xsl:choose>
 <xsl:when test="$type = 'bullet'">
 <xsl:text>circle</xsl:text>
 </xsl:when>
 <xsl:when test="$type = 'ordered'">
 <xsl:text>1.</xsl:text>
 </xsl:when>
 </xsl:choose>
 </xsl:attribute>
 <xsl:number />
 </fo:block>
 </fo:list-item-label>
 <fo:list-item-body start-indent="body-start()">
 <fo:block>
 <xsl:apply-templates />
 </fo:block>
 </fo:list-item-body>
 </fo:list-item>
</xsl:template>

<xsl:template match="md:list">
 
<fo:block-container column-count="2">
 <fo:list-block xsl:use-attribute-sets="attsListBlock">
 <xsl:apply-templates />
 </fo:list-block>
</fo:block-container>
</xsl:template>

箇条書き(リスト)です。それぞれの項目が短い場合、1段だと余白がかなり空いてしまいます。AH Formatterではブロックコンテナでも段組みを別に指定できるので、2段組にしてみました。今回使用してはいないものの、数字付き箇条書きでも動作します。CommonMarkのASTでは箇条書きは同じlist構造でtypeプロパティの値が違う形なので、HTMLのようにulとolが分けられているより対応が楽だと感じました。入れ子のリストでの記号の変更も、 <xsl:variable name="nest" select="count(ancestor::list)" />のようにすれば階層が割と簡単に分かりそうです。
ところでこの組版結果は想定とズレていて、ASTの<item>の内部で一度<paragraph>が使われているため、ラベルと項目の間に、通常の段落を想定した段落開始のインデントが入ってしまっています。

インライン記法の変換例を見てみましょう。

<xsl:attribute-set name="attsEm">
 <xsl:attribute name="axf:text-emphasis-style">dot</xsl:attribute>
 <xsl:attribute name="axf:text-emphasis-font-family">Kenten Generic</xsl:attribute>
 <xsl:attribute name="axf:text-emphasis-skip">spaces punctuation symbols narrow</xsl:attribute>
</xsl:attribute-set>

<xsl:template match="md:emph">
 <fo:inline xsl:use-attribute-sets="attsEm">
 <xsl:apply-templates />
 </fo:inline>
</xsl:template>

和文の簡易マークアップで悩ましいemとstrong。AH Fromatterでは圏点の拡張がありますから、emでは圏点を使用してみました。


今回の記事は『スタイルシート開発の基礎 XMLとFOで簡単な本を作ってみよう』[5]を片手に、適宜読み替えながら書き進めてみました。Markdownからの変換はLaTeXやHTML経由でのものが多く、それぞれに長所や特徴がありますが、XSL-FOで1つ1つ記法とFOを確かめながらというのも、組版全般やXSLTの学習がしっかり進んだように感じ、良いものです。
体感としては、一般的なプログラミング言語で同程度の内容を書くよりも3倍くらいの行数になっている感じがします。

*1XSLTとXSL-FOの記法について学習中の人間が執筆しました。誤りが含まれる箇所があるかもしれません。

*2 「不足する」他のものとしては、表示言語などもそうです。多くのXMLアプリケーションでは「xml:lang」や「id」といった情報は<xsl:copy-of>を利用して入力から出力へそのまま渡せますが、CommonMarkのASTにその情報は含まれません。<html_block>の情報としてマークアップを処理する、言語ごとにファイルを分けるなど、手軽な処理とはいかないでしょう。

*3 <template match="/">は個人的な感覚としては一般的なプログラミング言語におけるmain関数に近いので、切り出せる処理を適時追い出し、子の箇所で必要な値(で子からの取得が面倒なもの)については<xsl:with-param>で渡しています。<xsl:attribute>は調整する可能性がないものは<xsl:template>内でハードコード、そうでなければxsl:use-attribute-setsで別に切り出しています。2ページもない文書を処理するにしては冗長かもしれません。


参考資料

  1. [1] https://github.com/commonmark/cmark
  2. [2] https://commonmark.org/
  3. [3] 構造化文書とは – アンテナハウス
  4. [4] Markdown + XSL → PDF
  5. [5] スタイルシート開発の基礎 – アンテナハウス


Antenna House Formatter

DITA/XML Service Antenna House


関連記事

オンラインショップで簡単にお見積書(PDF)の作成 ~セールも開催中!~

オンラインショップで見積キャンペーン開催中

先月(2020年6月)より、アンテナハウスのオンラインショップで、商品のご購入前にお見積書(PDF)を発行できるようになりました。

オンラインショップにログインしていれば、商品を「カゴ」に入れて、「お見積」→「見積書をダウンロード」をクリックするだけで、その場でPDFのお見積書を自動で作成してダウンロードできます。

見積書をダウンロード

見積書をダウンロード

お見積書PDFのサンプル

お見積書PDFのサンプル

宛名の変更もできますので、会社で購入申請時にもご利用いただけます。

お見積書のPDFの発行は無料ですのでお気軽にお試しください。

弊社の自動組版ソフトでWebシステムからお見積書の作成

オンラインショップの見積書PDFの作成には、弊社の自動組版ソフト『Antenna House Formatter』をコマンドラインから利用して自動で生成しています。

見積用データとしてデータベースに登録されたデータから、見積書用に用意したスタイルシート(XSLT)を利用して動的にレイアウトし、PDFを出力しています。

セールも開催中!

現在、記念キャンペーンとして『瞬簡PDFファミリー』製品を2020年7月17日まで特価にて販売しています。

この機会にぜひお見積書の作成機能をお試しください。
(お見積り機能を利用しなくてもキャンペーン価格の商品はご購入いただけます。)

※キャンペーン価格のお見積の有効期限は、キャンペーン期間終了時までとなりますのでご了承ください。

→ お見積書の作成方法について詳しくは「見積り書の発行について」をご覧ください。
→ 見積キャンペーンはこちら(2020年7月17日まで)

PDFの色指定(5)CIEベースカラースペース

PDFにおけるCIEベースカラースペースは初回に紹介したように次の4つです。

  • CalGray
  • CalRGB
  • Lab
  • ICCBased

デバイスカラーベースと異なり、出力デバイスに依らず色を指定できます。出力時の処理では内部でXYZの3値による表現に変換され、このXYZがデバイスカラースペースに変換されます。そこからはデバイスカラースペースと同様に処理されます。

CalGrayはグレースペースの要素Aを用います。Aは0.0~1.0の値を取ります。値AをMatrix Aを使用しLMNの3値にデコードします。このLMNをそのままXYZとして使用します。
このMatrix Aを構成する値が、CalGrayに辞書型で格納される、CIEXYZに基づく白の基準値WhitePointと、黒の基準値BlackPointの3つの数値からなる配列と、輝度補正に使うGammaです。WhitePoint以外はオプションで、指定しなければ既定値を使用します。白と黒の基準値は、それぞれdiffuse white point、diffuse black pointと呼ばれるものです。

CalRGBでは入力値が増えます。CalRGBにに格納する辞書型は、GammaがRGBに対応する3値の配列になる他、Matrixというキーで3×3の行列が格納でき、XYZへ変換するときに補正値として用います。

PDFにおけるCIEベースカラースペースでのLabは正しくはCIE LABの方です。辞書型WhitePoint、BlackPointと、Rangeというa*、b*をそれぞれの最大値、最小値で指定する4つの数値の配列を格納しています。

最後にICCBasedカラースペースについてです。ICCカラープロファイルをストリーム型として格納できます。
追加として、サポートしていないデータがあった場合などに代替される設定名の配列Alternateや、ICCプロファイルで記述されているCoulor Componentの数Nを辞書型で格納します。PDF1.7ではICC. 1:2004-10に対応しています。

デバイス依存の色指定を、comformingなPDF writerは、機械的にCIEベースカラースペースに変換するよう要求できるとあります。

ISO 32000-1:2008にはこれらの詳細が数式・図表付きで記述されています。

参考

ISO 32000に準拠するPDFってどんなもの?


PDFの色指定について
デバイスカラースペース
PDFの色指定について(2)
色とは何か
PDFの色指定 (3)CIE1931 CIELuv CIELAB
CIEカラースペース
PDFの色指定(4)
ICCプロファイル

PDFの色指定(4) ICCプロファイル

前回、CIE1931、CIELAB、CIELUVについて触れました。
これらを活用し、様々なデバイスで色について統一的にマネジメントするための仕組みがICCプロファイルです。

International Color Consortium(ICC)[1]は、コンピュータやデジタルカメラ、スキャナ、プリンタなどのデバイス上で統一して色の管理を行うための標準化団体です。ベンダー8社を中心に1993年に設立されました。

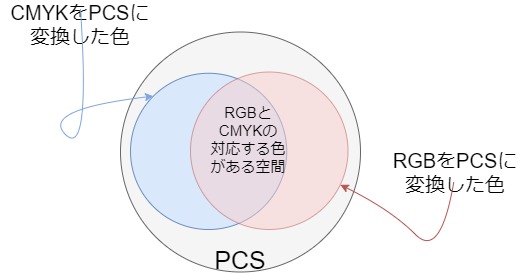
ICCプロファイルは基準となるカラースペースの定義と、それに基づく設定の記述によって構成されています。基準となるカラースペースはプロファイル接続空間(PCS)と呼ばれます。これは、CIEXYZやCIELABによるカラースペースに制限を加え、プロファイルに使用しやすいようにしたものです。PCSという共通のカラースペースがあることで、あるデバイスでの色の記述を、そのデバイスのプロファイルを使いPCSの色表現に変換し、それを別のデバイスプロファイルを使って別のデバイス上での色の記述に変換できます。またICCプロファイルには、色の記述をPCSでの色表現に変換するための共通のインターフェースという役割があります。
このインターフェースは、先に挙げたPCSとPCSに色の記述を変換する設定の書式を厳密に定めたもので、構造としては、ヘッダ部、タグのテーブル、タグに紐付いたデータで構成されます。変換アルゴリズムなどの実装については定めていません。

PCSからデバイスの色に変換する際に、そのままではデバイスで対応できない色が含まれる場合があります。そのときに対応していない色をどの色にマッピングするかを定める「レンダリングインテント」と呼ばれるものをICCプロファイルに用意できます。

caption: PCS

ICCプロファイルは、デバイスによって幾つかの種類に分けられます。主に次の3つです。

  • スキャナ、デジタルカメラなどのための入力プロファイル
  •  ディスプレイなどでの表示のためのディスプレイプロファイル
  •  プリンタなどのための出力プロファイル

他の種類もあります。

  • 画像形式での流通のためのカラースペースコンバージョンプロファイル
  • 特定の色のための命名色プロファイル
  • 追加の補正情報を埋め込むためのアブストラクトプロファイル

さらに、プロファイルを組み合わせて1つにした、デバイスリンクプロファイルがあります。

相互に色を変換するための共通の書式であるICCプロファイルについて概要を説明しました。
次回はようやく、PDFのCIEベースカラースペースについての回になる予定です。

[1] http://www.color.org/abouticc.xalter

PDFの色指定について
PDFの色指定の概要・デバイスカラースペース
PDFの色指定について(2)
色とは何か
PDFの色指定 (3)CIE1931 CIELuv CIELAB
CIEカラースペース
PDEの色指定(5)CIEベースカラースペース
PDFのCIEベースカラースペース格納形式と使用のされ方の概略